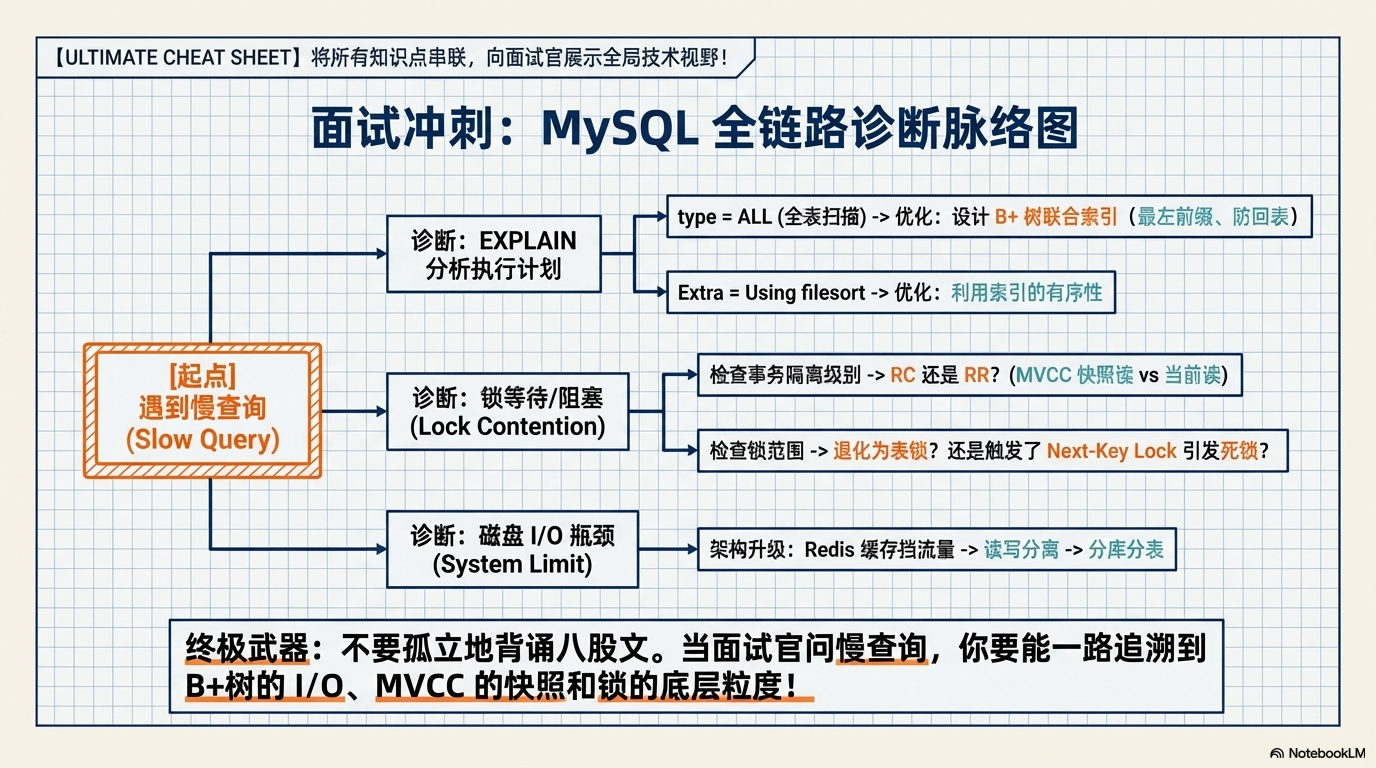
MySQL
归纳 MySQL 索引、事务和查询相关的常见面试知识点。
MySQL
InnoDB 索引
| 概念 | 含义 |
|---|---|
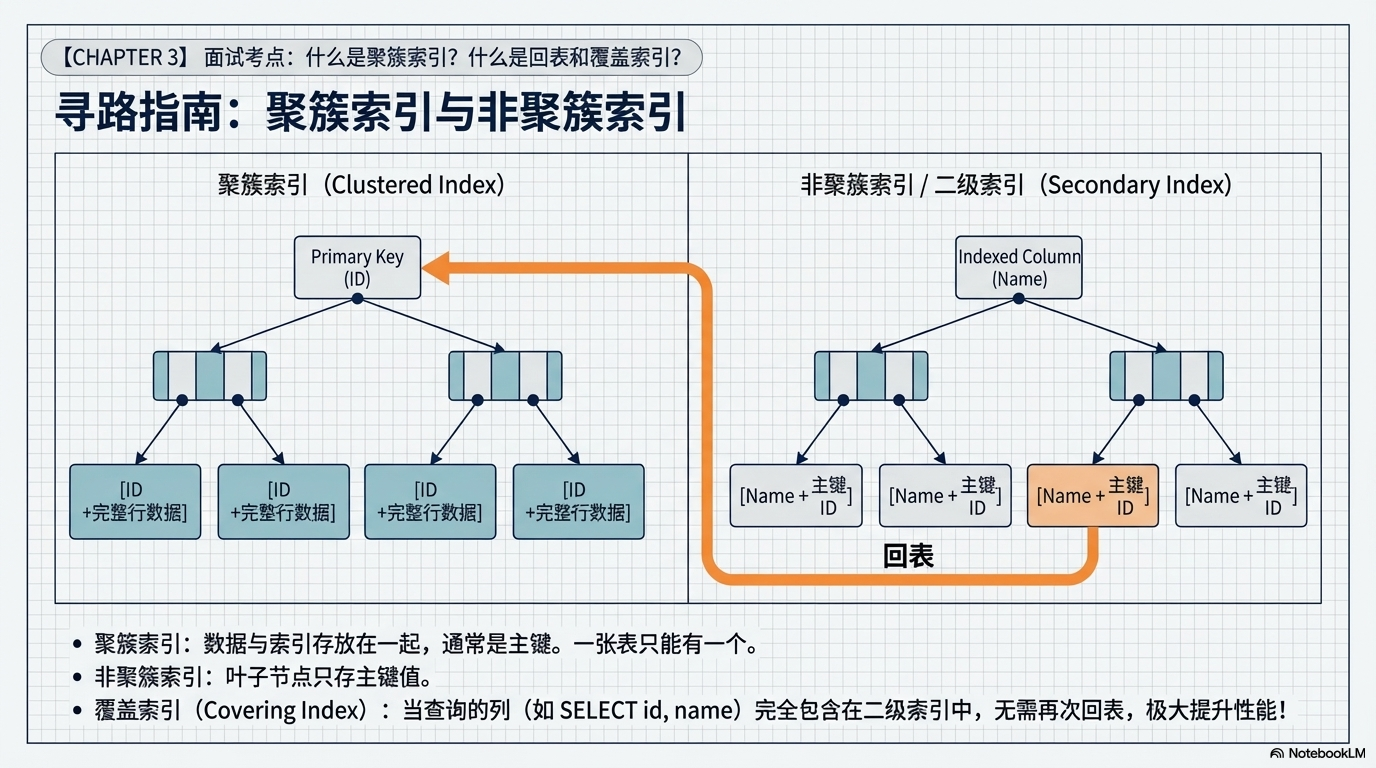
| 聚簇索引 | 叶子节点保存整行数据,一张表只有一个;优先使用主键,没有主键时选择合适的非空唯一索引,否则生成隐藏行 ID |
| 二级索引 | 叶子节点保存索引列和聚簇索引键;有显式主键时,保存的就是主键值 |
| 回表 | 先从二级索引找到主键,再到聚簇索引取其余列 |
| 覆盖索引 | 查询需要的列都能从当前索引取得,无需回表 |
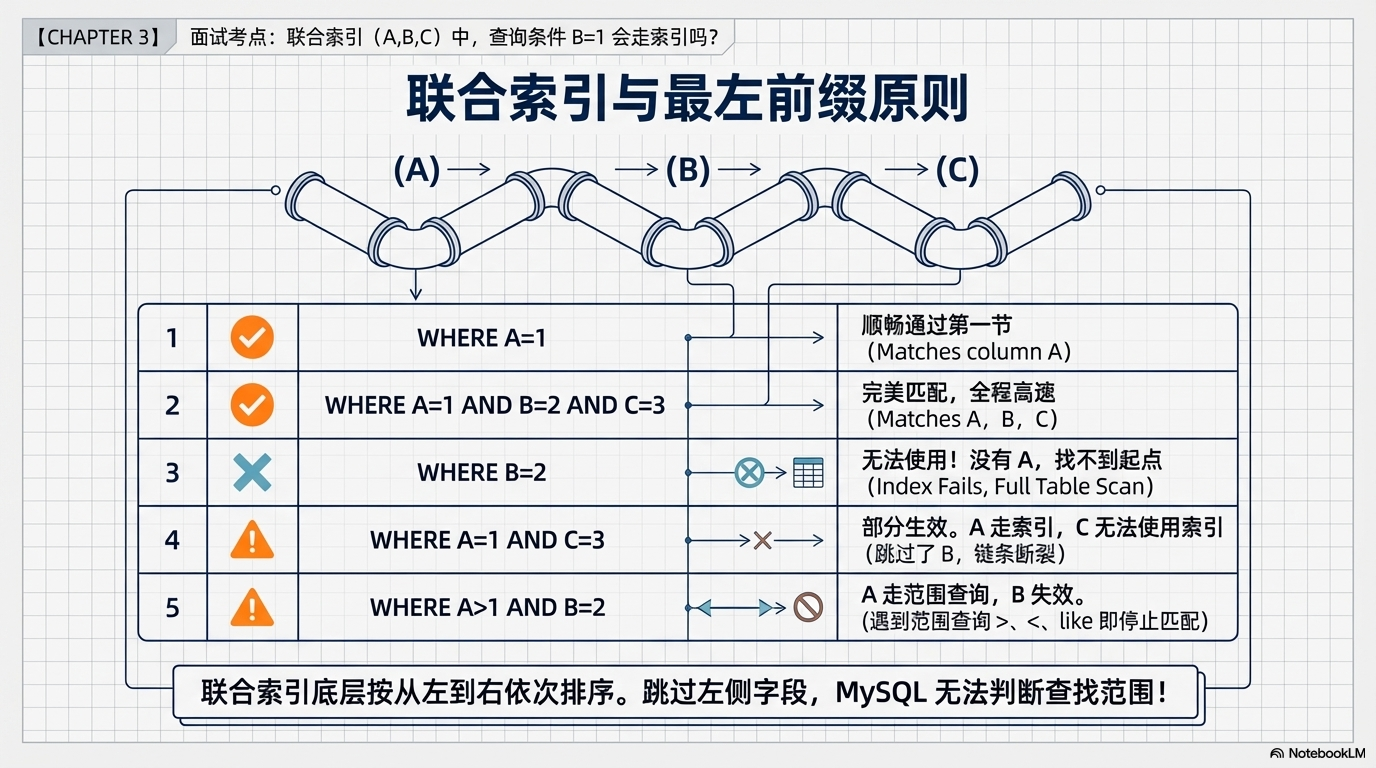
| 联合索引 | 多列按定义顺序组成一个索引 |
主键一张表只能有一个且不能为空;唯一索引可以有多个,可空列允许多个 NULL。违反唯一约束时,MySQL 通常返回错误码 1062、SQLState 23000,消息为 Duplicate entry ... for key ...;框架可能再封装为 DuplicateKeyException 等异常。
联合索引与 B+ 树
联合索引 (a, b, c) 按 a、b、c 的顺序排序,常规查找遵循最左前缀:可以使用 a、a+b、a+b+c。跳过前导列后的使用情况,要结合优化器能力和执行计划判断。
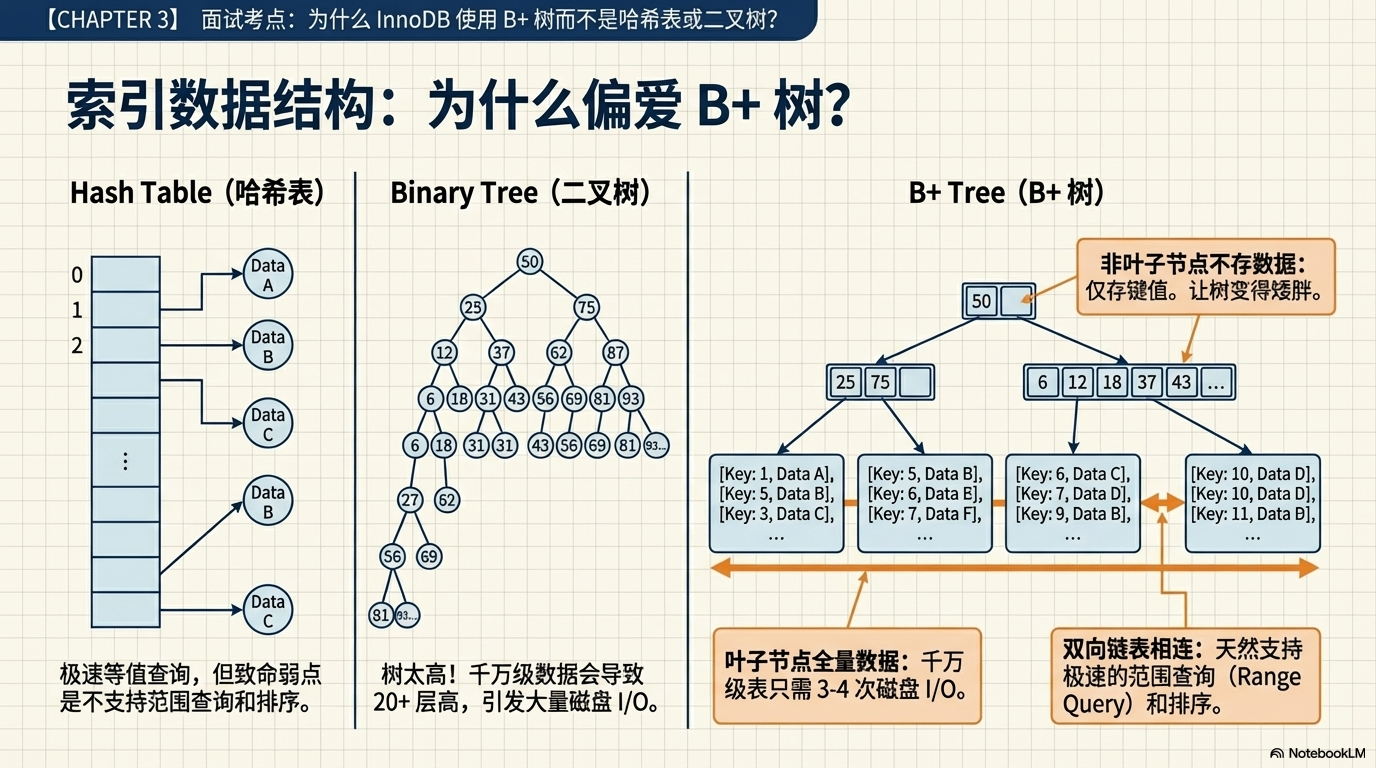
B+ 树的非叶子节点保存键和子节点指针,扇出大、树高低,能减少查找的页访问。叶子节点有序且相连,定位起点后可以连续扫描,适合范围查询。
怎么建、怎么查
围绕实际的 WHERE、JOIN、ORDER BY、GROUP BY 和唯一约束设计索引。考虑选择性、字段顺序和能否覆盖查询;索引越多,写入维护和存储成本越高。低选择性字段不一定值得单独建索引,但可以参与合适的联合索引。
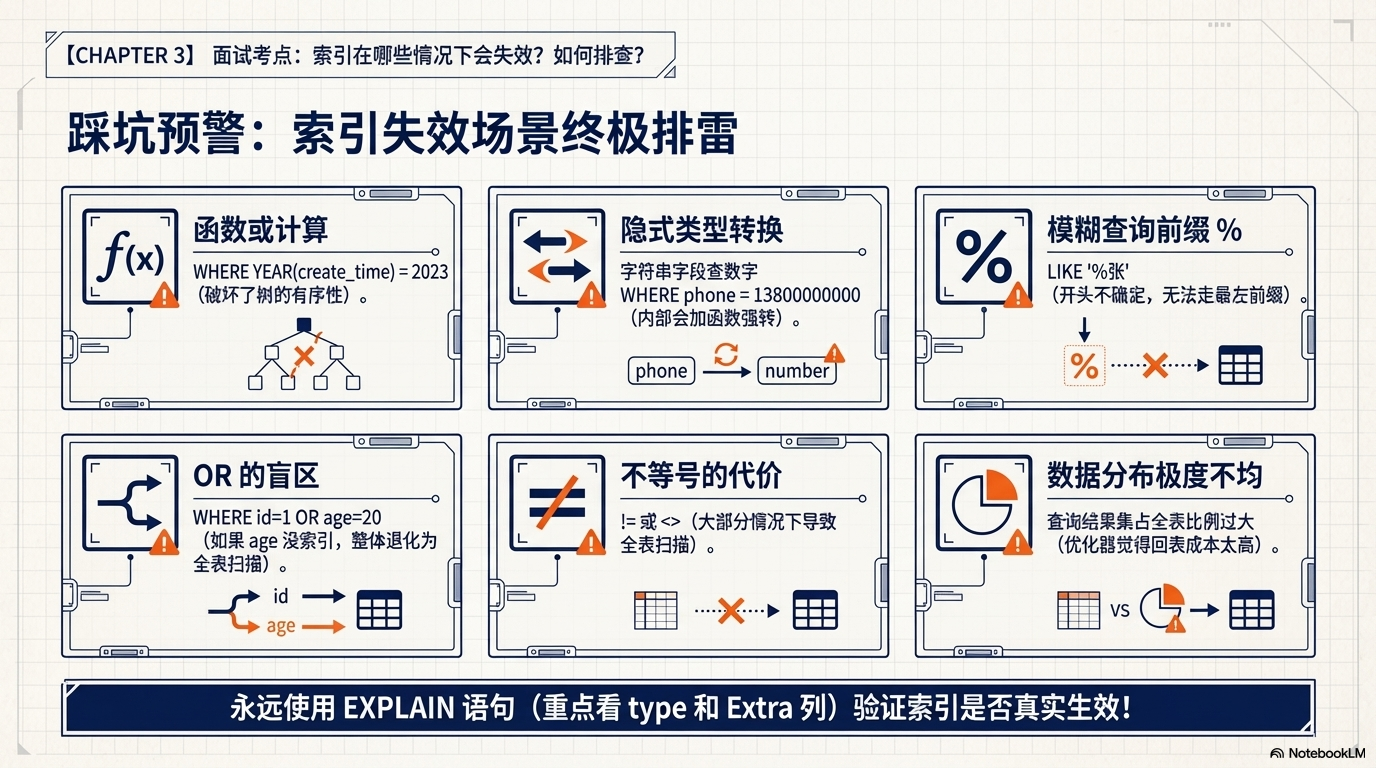
下面这些情况可能无法高效使用索引,最终用 EXPLAIN 验证:
| 情况 | 例子与处理 |
|---|---|
| 对索引列做函数或运算 | YEAR(create_time)=2023 可改为日期范围;函数索引另行考虑 |
| 隐式类型转换 | phone 是字符串时,用 phone='13800000000',保持类型一致 |
| 前导通配符 | LIKE '%张%' 难以用普通 B+ 树定位;LIKE '张%' 可按前缀查找 |
| OR 的部分条件缺少索引 | 可能退化为全表扫描;是否拆查询要同时检查去重语义和执行计划 |
| 命中行过多 | !=、低选择性条件可能让全表扫描更便宜,并非运算符一出现就“索引失效” |
事务与日志
| ACID | 含义 |
|---|---|
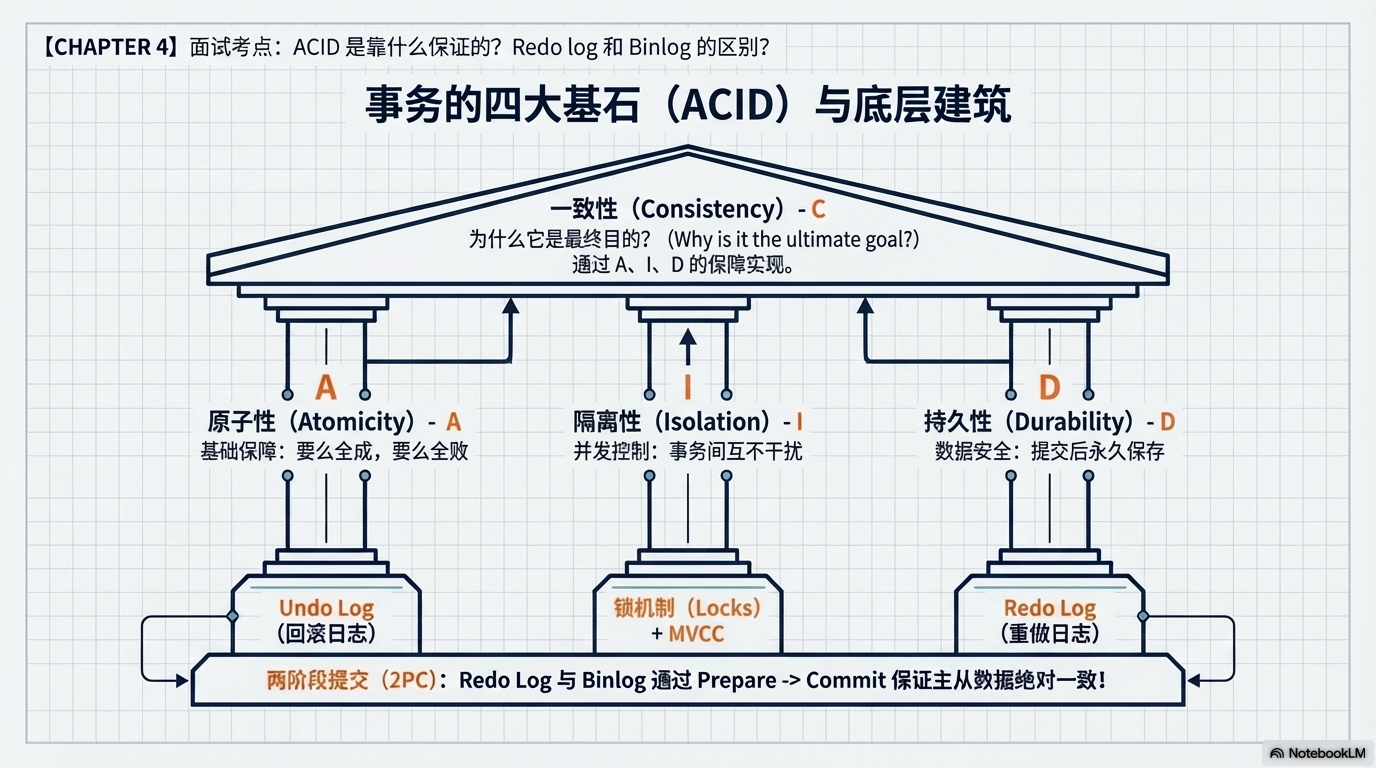
| 原子性 | 一组操作全部完成或全部撤销,例如转账的扣款和入账 |
| 一致性 | 事务前后满足约束;业务规则也需要应用正确实现 |
| 隔离性 | 按隔离级别控制并发事务之间的可见性和干扰 |
| 持久性 | 已提交结果可在故障后恢复;实际保证与刷盘等配置有关 |
| 日志 | 作用 |
|---|---|
| undo log | 保存回滚所需信息,也用于构建 MVCC 历史版本 |
| redo log | InnoDB 的重做日志,记录页修改所需信息,用于崩溃恢复,空间循环复用 |
| binlog | Server 层的二进制日志,用于复制和时间点恢复,按文件追加;可以记录语句或行变更 |
启用 binlog 时,InnoDB 与 binlog 通过内部两阶段提交协调:redo prepare → 写 binlog → InnoDB commit。故障恢复时据日志状态判断提交或回滚,避免两边结果不一致;提交时是否同步落盘取决于相关配置。
隔离级别与 MVCC
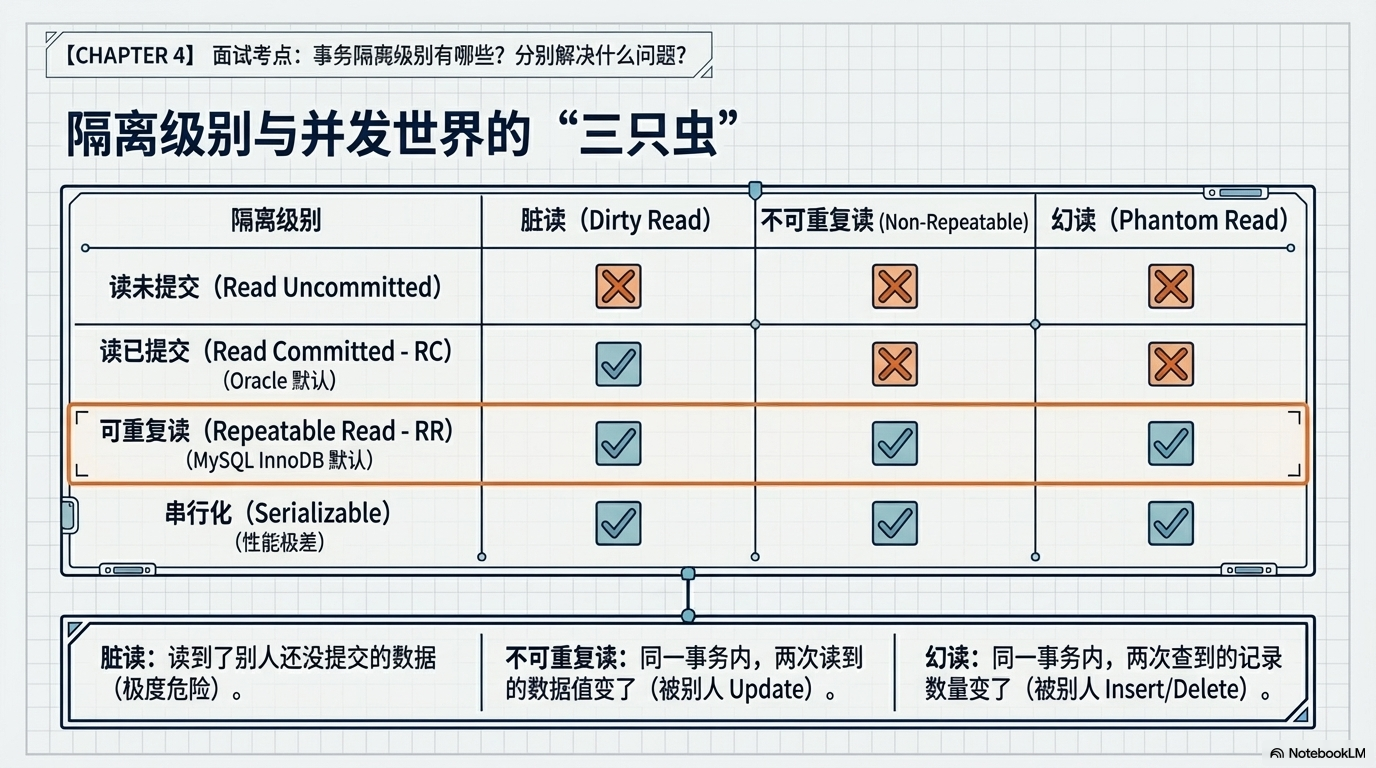
脏读是读到其他事务尚未提交的数据;不可重复读是同一行前后值不同;幻读是重复执行同一条件查询时,符合条件的行集合发生变化。
| 隔离级别 | InnoDB 中的主要行为 |
|---|---|
| RU:读未提交 | 普通读可能看到未提交数据 |
| RC:读已提交 | 每次一致性读建立新快照,可能不可重复读、出现幻读 |
| RR:可重复读(默认) | 一致性读通常复用第一次一致性读建立的快照;范围锁定读通过 next-key lock 等阻止区间内插入 |
| Serializable:串行化 | 提供可串行化的隔离,通常增加锁和等待,并非所有事务实际只按单线程排队执行 |
快照读与锁定读要分开理解:RC、RR 下普通 SELECT 通常使用 MVCC;SELECT ... FOR UPDATE / FOR SHARE、UPDATE、DELETE 读取并锁定较新的记录状态。RR 中混用两者,不能假设它们始终看到同一份数据。参见 InnoDB 隔离级别。
MVCC 如何判断可见性
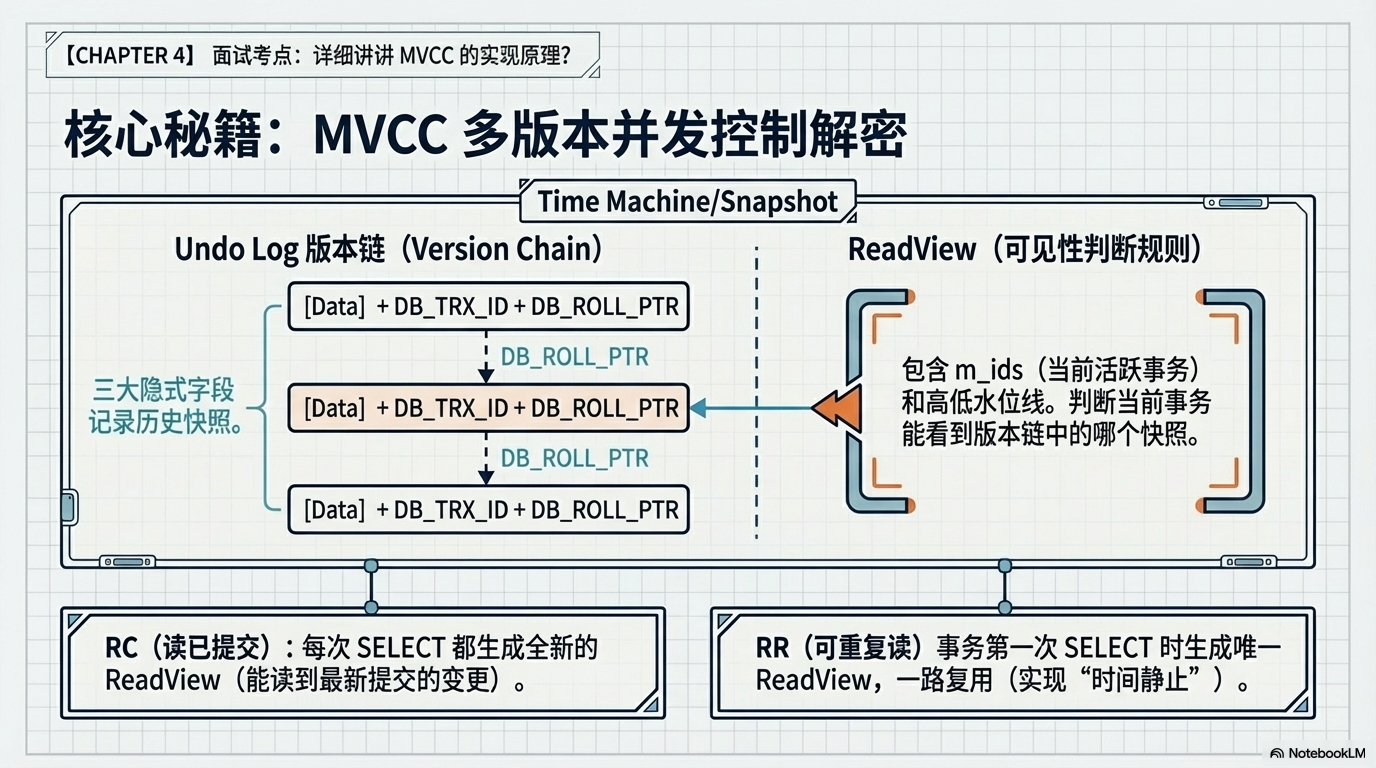
MVCC 通过行版本、undo log 和 Read View 实现一致性读。当前版本不可见时,沿 undo 链寻找更早的可见版本。
DB_TRX_ID:最后修改该行的事务 ID。DB_ROLL_PTR:指向 undo 记录,供回滚和历史版本重建。DB_ROW_ID:没有可用的主键或非空唯一索引时生成的隐藏行 ID。- 删除标记:删除后先标记,待旧版本不再需要时再清理。
Read View 保存创建者事务 ID、创建时仍活跃的读写事务 ID 集合,以及事务 ID 的上下边界。判断规则是:
- 自己写入的版本可见。
- 快照创建前已提交的版本可见。
- 创建时仍活跃,或快照创建后才开始的事务版本不可见,需要继续找旧版本。
常见讲解中的 min_trx_id 是活跃事务下界,max_trx_id 是当时下一个待分配事务 ID;中间区间需要检查活跃集合 m_ids。这些名称是理解用的抽象,源码字段名可能不同。
锁
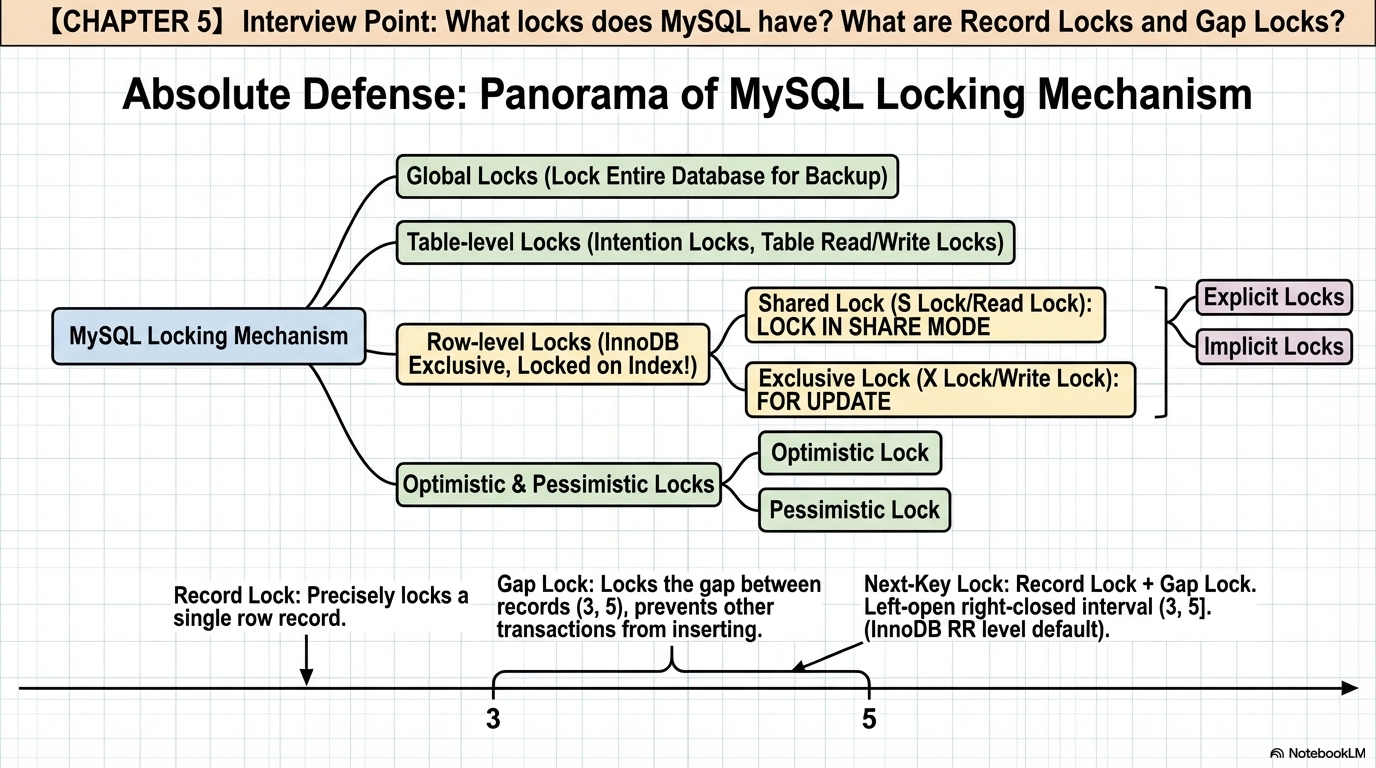
锁可以作用于全局、表或索引记录。InnoDB 的“行锁”实际加在索引记录上;是否锁间隙、锁多少记录,取决于隔离级别、索引和查询条件。
| 类型 | 作用 |
|---|---|
| 共享锁 S / 排他锁 X | 同一记录上 S 与 S 兼容,X 与其他 S/X 冲突;普通 MVCC 快照读通常仍可读取旧版本 |
| 意向锁 IS / IX | 表级标记,表示事务已持有或准备获取记录上的 S/X 锁,协调表锁与行锁 |
| 记录锁 | 锁住索引记录;唯一索引等值命中现有记录时通常只需记录锁 |
| 间隙锁 | 阻止向索引间隙插入数据 |
| Next-key lock | 记录锁加该记录前方的间隙锁;RR 范围查询中常见 |
| 元数据锁 MDL | 保护表结构,协调 DML 与 DDL |
FOR UPDATE 显式请求排他锁;FOR SHARE 请求共享锁;UPDATE、DELETE 自动获取所需的排他锁。锁的实际范围要看执行计划,不能只看 SQL 中是否写了主键条件。
乐观锁通过版本号或条件更新检测冲突,适合冲突较少且可重试的操作;悲观锁先锁定再修改,适合竞争较强且临界区较短的操作。两者都需要正确处理失败,不能仅凭“库存”“余额”等业务名决定。
连接池与缓存
连接池复用数据库连接并限制连接总数。主要关注最大连接数、空闲连接数、连接寿命、空闲超时、获取连接的等待时间和健康检查;具体配置项因客户端而异。线程池复用的是执行线程,关注线程数、任务队列和拒绝策略。
是否加本地缓存、Redis 等缓存层,不能只看“数据库能扛 2k QPS”。先测热点、峰值、尾延迟、连接和 CPU 压力,再判断收益是否抵得过失效策略与一致性成本。
全链路示意